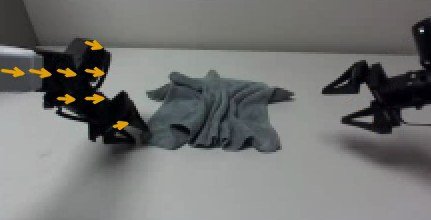
Ein neues Robotikmodell namens ModAR stellt eine verbreitete Annahme bei World Models infrage: Muss ein Roboter wirklich komplette zukünftige Bilder erzeugen, um die Folgen seiner Handlungen zu verstehen? Die Forscher zeigen, dass kompaktere Informationen über Bewegung, Tiefe und Bildinhalte für die Steuerung teilweise wichtiger sein können als die Vorhersage vollständiger RGB-Bilder.
ModAR wurde von Forschern um Adam Hung, Bardienus P. Duisterhof, Deva Ramanan und Jeffrey Ichnowski entwickelt. Das Modell gehört zur Klasse der sogenannten World-Action Models – Systeme, die nicht nur Roboteraktionen erzeugen, sondern gleichzeitig versuchen vorherzusagen, wie sich die Umgebung nach einer Handlung verändern wird.
Viele aktuelle Ansätze nutzen dafür Video- oder Bildgenerierungsmodelle. Der Roboter erzeugt vereinfacht gesagt eine Vorstellung davon, wie die Welt nach seiner nächsten Bewegung aussehen könnte.
ModAR geht einen anderen Weg.
Erst Bewegung und Struktur, dann Aktion
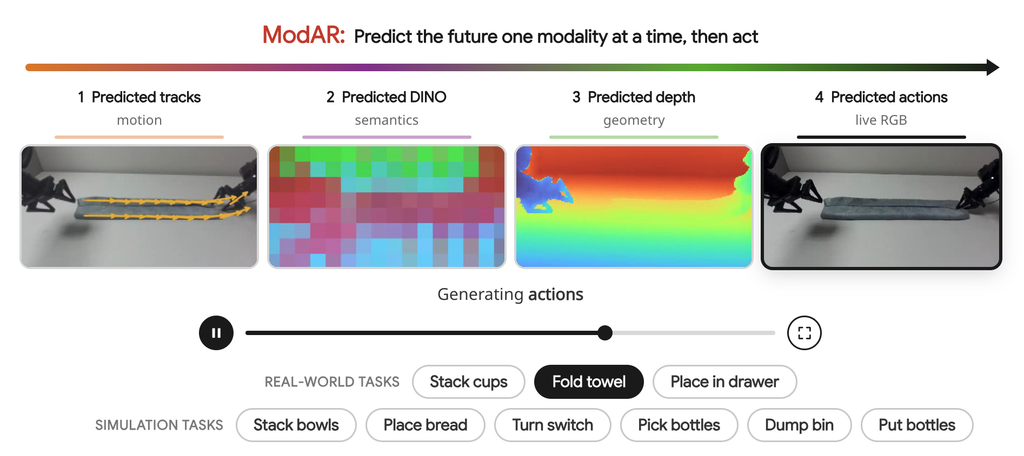
Statt die Zukunft hauptsächlich als RGB-Bild vorherzusagen, verarbeitet ModAR mehrere unterschiedliche Repräsentationen nacheinander.
Dazu gehören Point Tracks, die Bewegungen bestimmter Bildpunkte verfolgen, DINO Features für semantische Bildinformationen sowie Depth Maps, die die räumliche Struktur einer Szene beschreiben.
Diese Informationen werden nicht gleichzeitig erzeugt. ModAR sagt sie schrittweise voraus und verwendet jede bereits erzeugte Repräsentation als zusätzlichen Kontext für die nächste.
Erst danach erzeugt das Modell die eigentliche Roboteraktion.
Die Grundidee: Ein Roboter muss für viele Manipulationsaufgaben nicht wissen, wie jede Textur oder jeder Lichtreflex im nächsten Bild aussehen wird. Wichtiger kann sein, wohin sich ein Objekt bewegt, wie weit es entfernt ist und welche Teile einer Szene semantisch relevant sind.
RGB-Bilder bringen nicht immer einen Vorteil
Genau hier liefern die Experimente ein interessantes Ergebnis.
Die Forscher verglichen unterschiedliche Varianten von World-Action Models und stellten fest, dass die Vorhersage von Point Tracks, DINO Features und Tiefeninformationen die Leistung verbessert.
Die zusätzliche Vorhersage zukünftiger RGB-Bilder brachte dagegen keinen konsistenten Vorteil.
Bei den späteren Tests auf realen Robotern verzichteten die Forscher deshalb vollständig auf die RGB-Vorhersage und ließen ModAR nur Point Tracks, DINO Features und Depth vorhersagen, bevor das Modell seine Aktionen erzeugte.
Damit stellt die Arbeit zumindest für die getesteten Manipulationsaufgaben eine verbreitete Richtung aktueller World Models infrage: Mehr visuelle Detailtreue bedeutet nicht automatisch bessere Robotersteuerung.
75 Prozent gegenüber 72 Prozent bei deutlich weniger Training
ModAR wurde von Grund auf neu trainiert und nicht mit einem großen vortrainierten Videomodell initialisiert.
In einem Vergleich mit Flex-π, einem World-Action Model auf Basis eines vortrainierten Videomodells, erreichte ModAR eine durchschnittliche Erfolgsrate von 75 Prozent gegenüber 72 Prozent.
Nach Angaben der Forscher benötigte das Training dabei ungefähr 20-mal weniger FLOPs.
Der Vergleich ist allerdings mit Vorsicht zu lesen: ModAR und Flex-π unterscheiden sich nicht nur in der Modellarchitektur, sondern auch beim Pretraining. Das Ergebnis zeigt deshalb nicht, dass kleinere Modelle grundsätzlich große Videomodelle schlagen.
Interessanter ist vielmehr, dass ein relativ kompakter, von Grund auf trainierter Ansatz konkurrenzfähige Ergebnisse erreichen kann, ohne zunächst ein vollständiges Videoverständnis vortrainieren zu müssen.
Menschliche Videos helfen auch ohne Roboteraktionen
Getestet wurde ModAR außerdem auf drei realen Zweiarm-Manipulationsaufgaben.
Dazu gehörten das Stapeln von Bechern, das Falten eines zerknitterten Handtuchs sowie das Ablegen eines Gegenstands in einer Schublade mit anschließendem Schließen.
Über die drei Aufgaben hinweg erreichte ModAR in den veröffentlichten Experimenten eine Erfolgsrate von 83,3 Prozent. Eine reine Action-Only-Policy kam im gleichen Versuchsaufbau auf 52,2 Prozent.
Bemerkenswert ist auch, dass zusätzliche menschliche Videos die Leistung weiter verbessern konnten – obwohl diese Videos keine aufgezeichneten Roboteraktionen enthielten.
Das ist für Robot Learning relevant, weil echte Teleoperationsdaten teuer sind. Videos menschlicher Handlungen lassen sich dagegen wesentlich einfacher und in größeren Mengen sammeln.
Für World Models könnte weniger manchmal mehr sein
ModAR löst das Problem allgemeiner Roboterintelligenz noch lange nicht. Die Experimente umfassen sechs simulierte und drei reale Aufgaben und verwenden klar definierte Task Labels. Ob sich der Ansatz auf offene, komplexe Alltagsaufgaben übertragen lässt, bleibt offen.
Trotzdem trifft die Arbeit einen wichtigen Punkt in der aktuellen World-Model-Debatte.
Wenn ein Roboter eine Tasse greifen will, muss er möglicherweise keine fotorealistische Vorstellung davon erzeugen, wie die Küche eine Sekunde später aussieht. Entscheidend ist vielmehr, ob er versteht, wo sich die Tasse bewegen wird, wie die Geometrie der Szene aussieht und welche Veränderung seine eigene Aktion verursacht.
ModAR deutet damit auf eine interessante Richtung hin: Für Roboter könnte ein gutes Weltmodell weniger davon abhängen, wie realistisch es die Zukunft „filmen“ kann – und stärker davon, ob es genau die Informationen vorhersagt, die für die nächste Handlung tatsächlich relevant sind.